先看成品:一座「穿越」主题的游戏化学习站
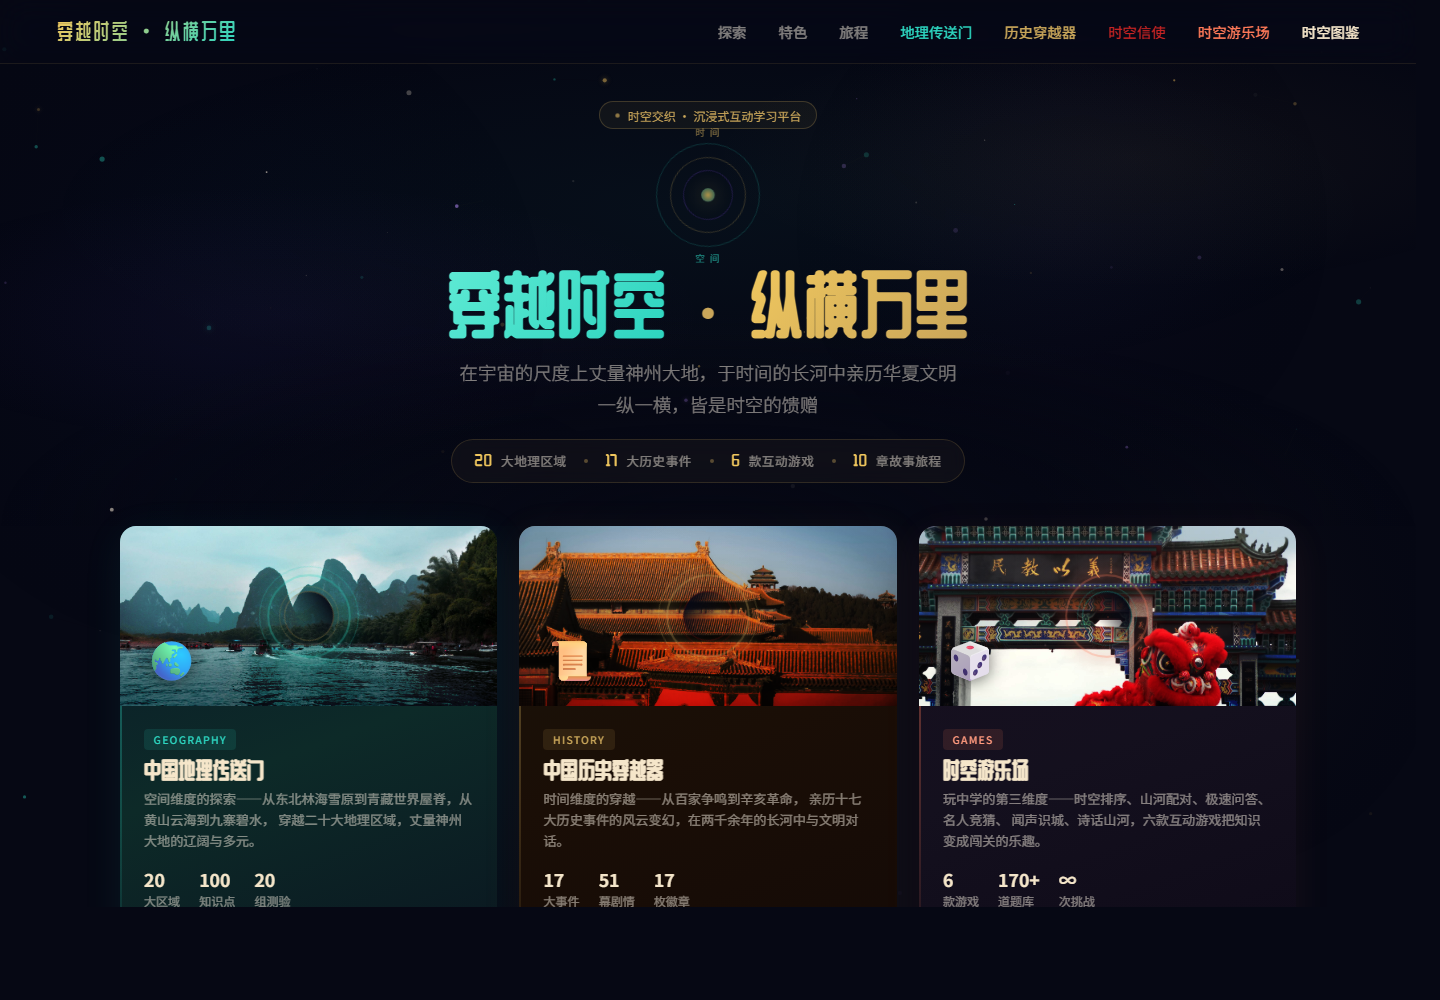
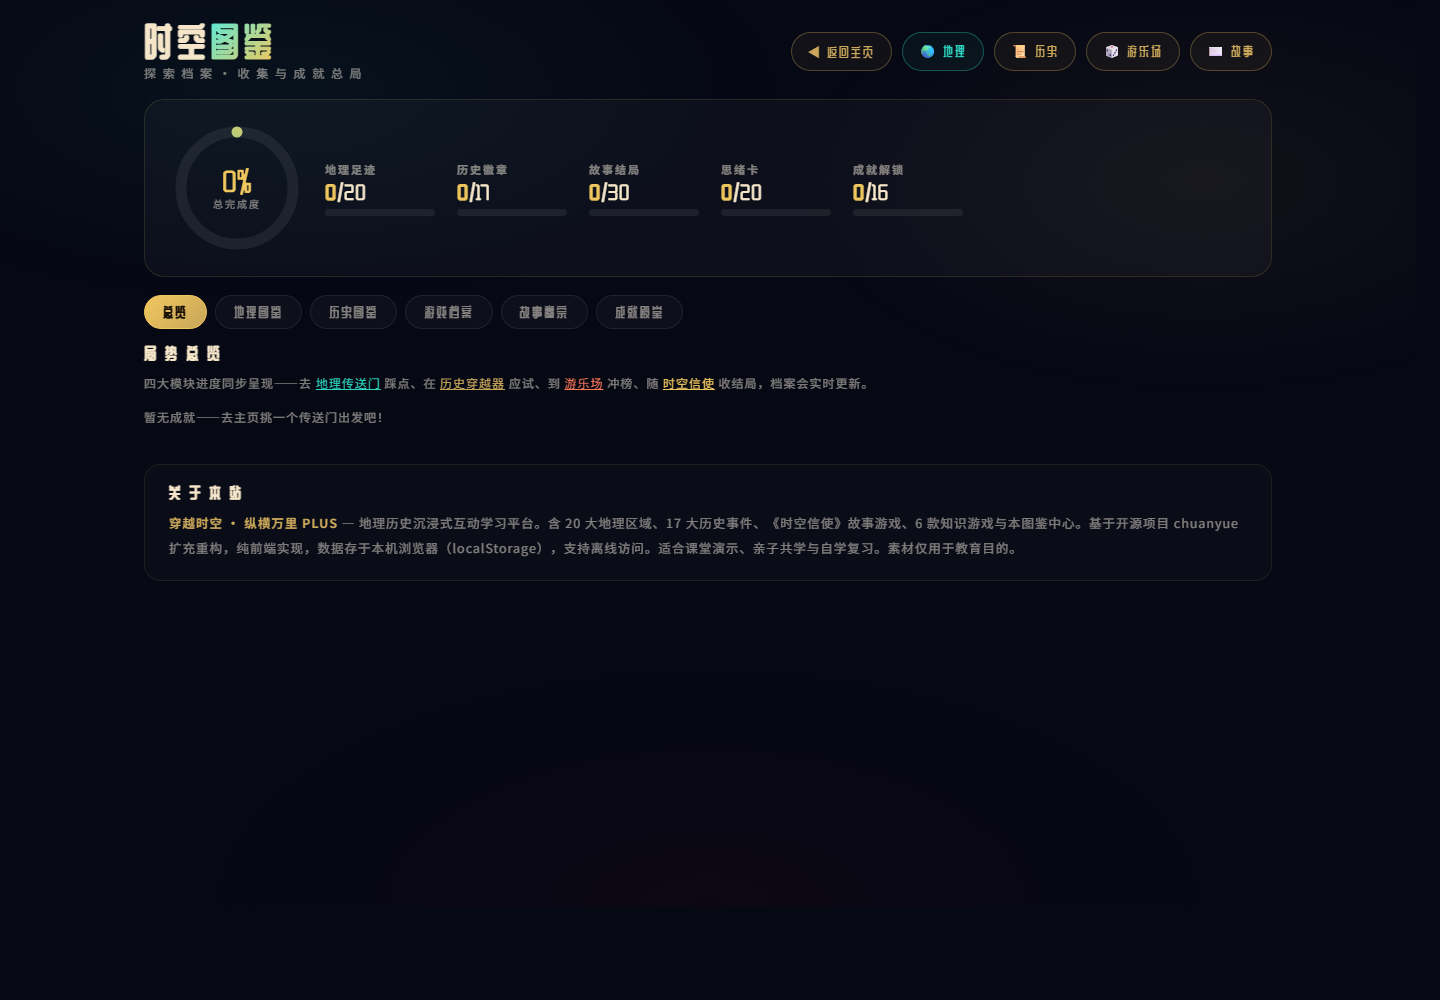
这个站点叫 穿越 PLUS,是一个纯前端的地理历史沉浸式学习平台。它有五个入口:地理传送门、历史穿越器、时空信使(故事)、时空游乐场(游戏)、时空图鉴(成就)。全部数据存在浏览器本机,不依赖后端。
生成原理:整站 = 数据 × 引擎 × 外壳
很多人做游戏化课件失败,是因为把「内容」「玩法」「界面」混在一句话里交给 AI。结果要么游戏不好玩,要么知识是硬塞进去的,改一处就全崩。这个站点能长起来,靠的是一开始就分了三层:
知识点、题库、剧情文本
20 个区域、17 个事件、80 道问答题、20 句诗词——都是结构化数组。它决定「教什么」。
判定规则、计分、存档
排序是否正确的比较逻辑、配对步数、localStorage 读写。它决定「怎么玩」。
配色、卡片、转场、PWA
深空主题、金色标题、响应式栅格、离线缓存。它决定「看起来像什么」。
原理一:数据要先定「形状」,AI 才能往里填
看这个站点里的真实代码结构——`youxi/index.html` 把六款游戏的最佳成绩统一交给两个小函数管理:
▲ 摘自 youxi/index.html(已简化显示)
这就是「先定数据形状」的好处:游戏模块不知道图鉴模块存在,但图鉴能读到它的成绩。每一轮加新游戏,只要往这个协议里加一个键,不用改前面任何代码。这就是站点能从 3 页长到 5 模块而不崩的原因。
原理二:新功能用「追加」而不是「重写」
README 里那张「原版 / 本版」对照表,其实就是一份迭代日志:
| 轮次 | 在原版之上追加了什么 | 有没有动原有代码 |
|---|---|---|
| 第 1 轮 | 8 大区域 → 20 大区域;8 大事件 → 17 大事件 | 只加数据条目 |
| 第 2 轮 | 新增「时空游乐场」6 款游戏 | 新增一个目录 |
| 第 3 轮 | 新增《时空信使》分支叙事(10 章 × 3 结局) | 新增一个目录 |
| 第 4 轮 | 新增「时空图鉴」成就系统(16 项成就) | 读取既有数据 |
| 第 5 轮 | PWA 离线、View Transitions 转场、数据校验器 | 只加外壳 |
原理三:难的东西放到后面做
分支叙事(时空信使)是全站最难的一块——10 章、30 种结局、自动存档。它被放在第四轮,而不是第一轮。原因很简单:分支叙事需要「读档」,而读档依赖前面已经建好的 localStorage 协议;如果一开始就做故事,存档格式会和后面加的游戏打架。
这条原理翻译成提示词就是:先做能被复用的地基,再做依赖地基的上层。地基是数据协议和页面骨架,上层是具体玩法。
五轮提示词,怎么把这个站一步步做出来
先立骨架:一个主题、三个页面、一套数据格式
产出:主页 + 地理 + 历史原版只有三页。第一轮要做的不是加功能,而是把「这个站是什么」定死:主题、视觉语言、数据长什么样、页面怎么跳转。提示词里必须出现「纯静态、无后端、数据用数组、localStorage 存档」这几个约束。
▲ 可复制;把 N 换成你的学科条目数
为什么这样写:最后那句「先输出目录结构与字段定义,我确认后再写代码」就是三步法的第一步——只要规格,不要成品。没有这一步,后面四轮都会建立在随意生成的结构上。
加游戏层:先做「机制库」,再做具体游戏
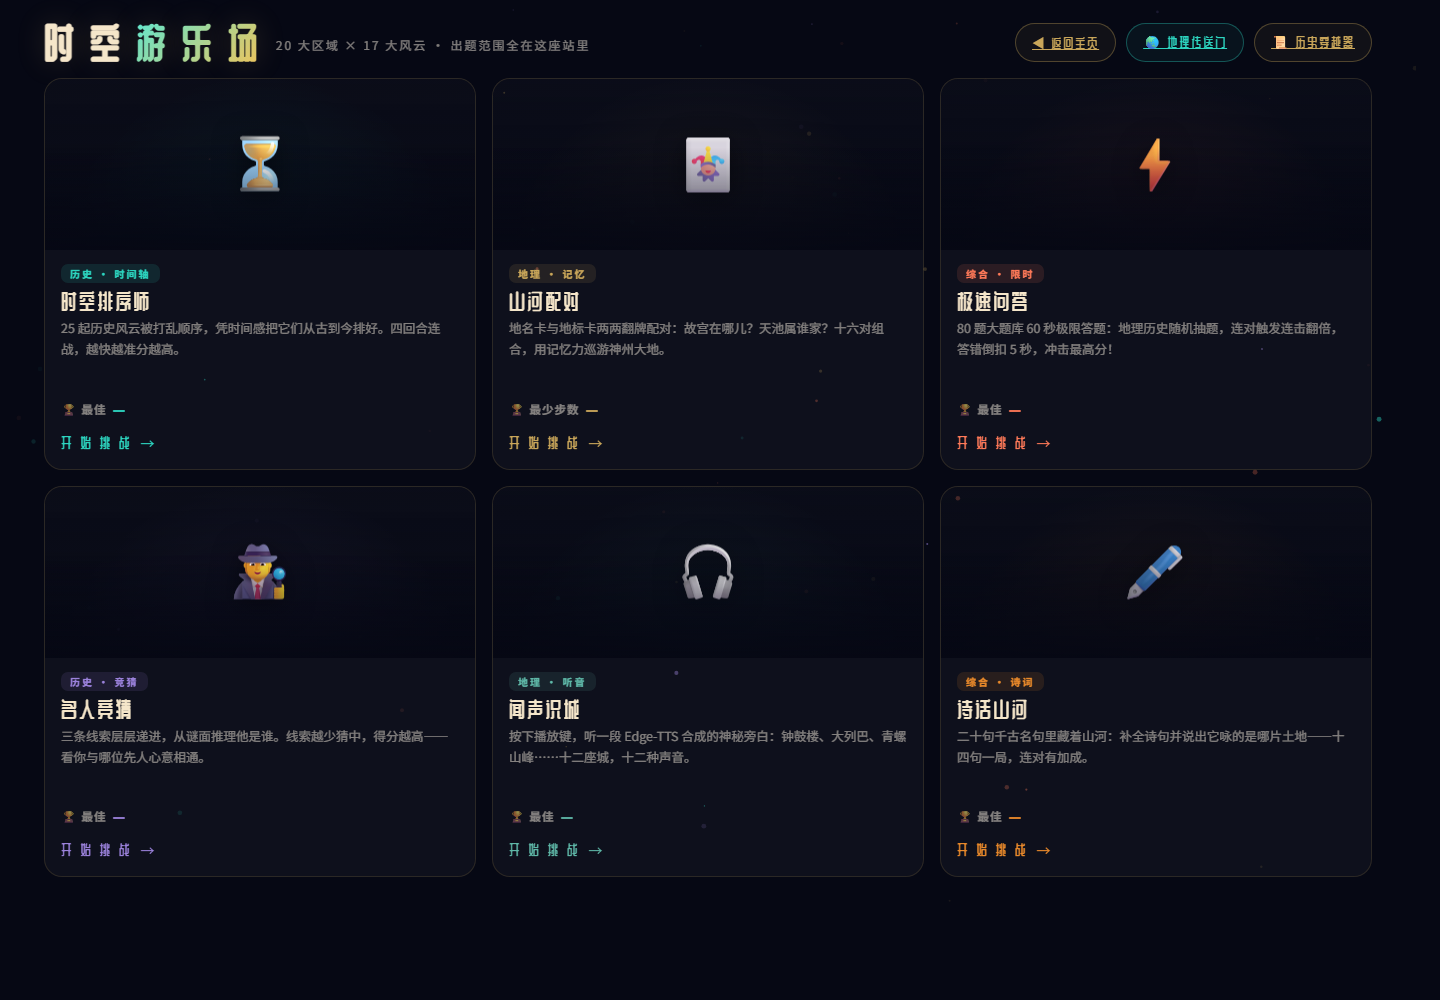
产出:6 款游戏 + 统一成绩协议第二轮不是「做六个游戏」,而是先定六种机制,再各填一批数据。看懂这六款游戏的分类,你就看懂了游戏化设计的全貌:
| 游戏 | 知识动作 | 机制内核 |
|---|---|---|
| 时空排序师 | 把事件按年代排序 | 顺序判定 + 4 回合 |
| 山河配对 | 地名与图像对应 | 32 卡翻牌 + 步数计分 |
| 极速问答 | 快速回忆知识点 | 80 题 + 60 秒连击 |
| 名人竞猜 | 由线索推人物 | 16 人 × 每局 6 题 |
| 闻声识城 | 听音频线索猜城市 | TTS 音频 + 12 城 |
| 诗话山河 | 名句填空 + 判断所咏地 | 20 句 × 每局 14 句 |
▲ 关键在「先做第一款跑通协议」
为什么这样写:六款游戏看着多,其实只用了同一套存档 + 六种判定。先跑通一款,等于验证了「数据→动作→判定→存档」这条链路,后面五款只是换数据。这就是「慢就是快」——一轮只解决一个新机制。
加故事层:最难的放这里,因为它要「读档」
产出:10 章 × 3 结局分支叙事第三轮做《时空信使》。它和其他游戏不一样:玩家的选择会累积成「历史契合度」,结局由整个过程决定,还能关掉页面下次接着玩。这依赖前面已经建好的存档协议——这就是为什么它不能放在第一轮。
▲ 注意「复用现有 localStorage 协议」这句
为什么这样写:「复用」两个字省掉了最大的隐患。如果这里让 AI 另写一套存档,前面六款游戏的成绩和故事进度就会互相覆盖——这类 bug 在整站项目里最难查。约束它复用,是把风险锁死在地基里。
回收数据:做一个把前面所有模块串起来的图鉴
产出:完成度环 + 16 项成就到第三轮为止,四个模块各存各的数据,玩家看不到全貌。第四轮做「时空图鉴」——它不产生新内容,只读取前面所有模块的存档并汇总。这是整站从「几个页面」变成「一个产品」的关键一步。
▲ 「只读不写」是这一轮的灵魂
为什么这样写:图鉴是最容易写出 bug 的地方——因为它要碰所有模块。明确告诉 AI 只读不写,等于给它画了红线:你只能看,不能改。这一轮之后,站点就有了「整体感」,学生会为了填满图鉴回头去玩前面的模块。
上外壳:PWA、转场、校验器——让它像产品而不是作业
产出:可安装 + 离线 + 1100 项自检最后一轮不动内容,只提升工程质量:让它能被安装到桌面、断网也能打开、页面切换有转场、数据有自动校验。这些都不改变教学内容,但决定了作品能不能真正拿去用。
▲ 最后一轮让作品「能交付」
为什么这样写:校验器看着和教学无关,其实是最值钱的一件工具。当站点有 240 个文件、上千条数据时,人眼查不过来;一个能自动报错的脚本,等于给 AI 的每次扩充装了安全网。
迁移到你的学科:把「穿越」换成你的教学内容
| 原站模块 | 机制 | 换成语文 / 数学 / 英语时 |
|---|---|---|
| 地理传送门 | 条目卡片 + 属性 + 小测 | 作家作品卡 / 公式定理卡 / 语法点卡 |
| 历史穿越器 | 3 幕剧情 + 对话 + 测验 | 课文情境再现 / 解题过程分幕 |
| 时空排序师 | 按时间排序 | 按情节先后 / 按解题步骤排序 |
| 山河配对 | 图与名对应 | 字形与字义 / 图形与公式配对 |
| 闻声识城 | 听音频线索猜答案 | 听单词辨拼写 / 听古诗猜作者 |
| 时空图鉴 | 跨模块成就汇总 | 学习档案 + 知识点掌握度总览 |
和本站「三步法」的关系
这一篇讲的是整站级的三步法:第 1 轮就是「写规格书」,第 2–4 轮是「按规格书分模块生成」,第 5 轮是「观察优化」。和单课件三步法完全同构,只是把「一屏」换成了「一个模块」,把「六看清单」换成了「数据校验器 + 试玩验收」。
可复制的整站规格书提示词
▲ 复制后把【】里的内容换成你的学科即可